Forelesning 1: Kjemiske biblioteker og molekylvisualisering#
I denne forelesningen skal vi bruke Python-biblioteker som er laget for kjemi. Vi skal:
hente grunnstoffdata med
mendeleevog undersøke trender i periodesystemethente data om forbindelser fra PubChem med
pubchempylese inn molekyler fra SMILES og beregne egenskaper med
RDKitlage 3D-strukturer og visualisere molekyler og proteiner med
py3Dmolvurdere når vi bør bruke et bibliotek, og når vi heller bør skrive koden selv
Målet er ikke å huske syntaksen til hvert bibliotek. Målet er å kunne bruke dokumentasjonen, løse kjemiske problemer med bibliotekene og kontrollere om resultatene gir mening. Underveis øver vi på lister, løkker, if-tester, funksjoner og dictionarier.
Hvorfor bruke biblioteker?#
Et bibliotek er kode som andre har skrevet, testet og gjort tilgjengelig. Biblioteker er særlig nyttige når de gir oss
data: kvalitetssikrede verdier, for eksempel ioniseringsenergier og atomradier
algoritmer og visualisering: funksjonalitet som er krevende å programmere selv, for eksempel å tegne strukturformler eller lage 3D-strukturer
standardisering: filformater og konvensjoner som gjør at ulike programmer kan utveksle data
Del |
Bruksområde |
Bibliotek |
|---|---|---|
1 |
Grunnstoffdata |
|
2 |
Data om forbindelser |
|
3 |
Struktur og egenskaper |
|
4 |
3D-visualisering |
|
5 |
Beregninger vi skriver selv |
egne funksjoner |
Installasjon#
Kjør cellen nedenfor én gang. Prosenttegnet gjør at kommandoen sendes til pakkebehandleren pip i stedet for å tolkes som Python-kode.
%pip install mendeleev pubchempy rdkit py3dmol
Del 1: Grunnstoffdata med mendeleev#
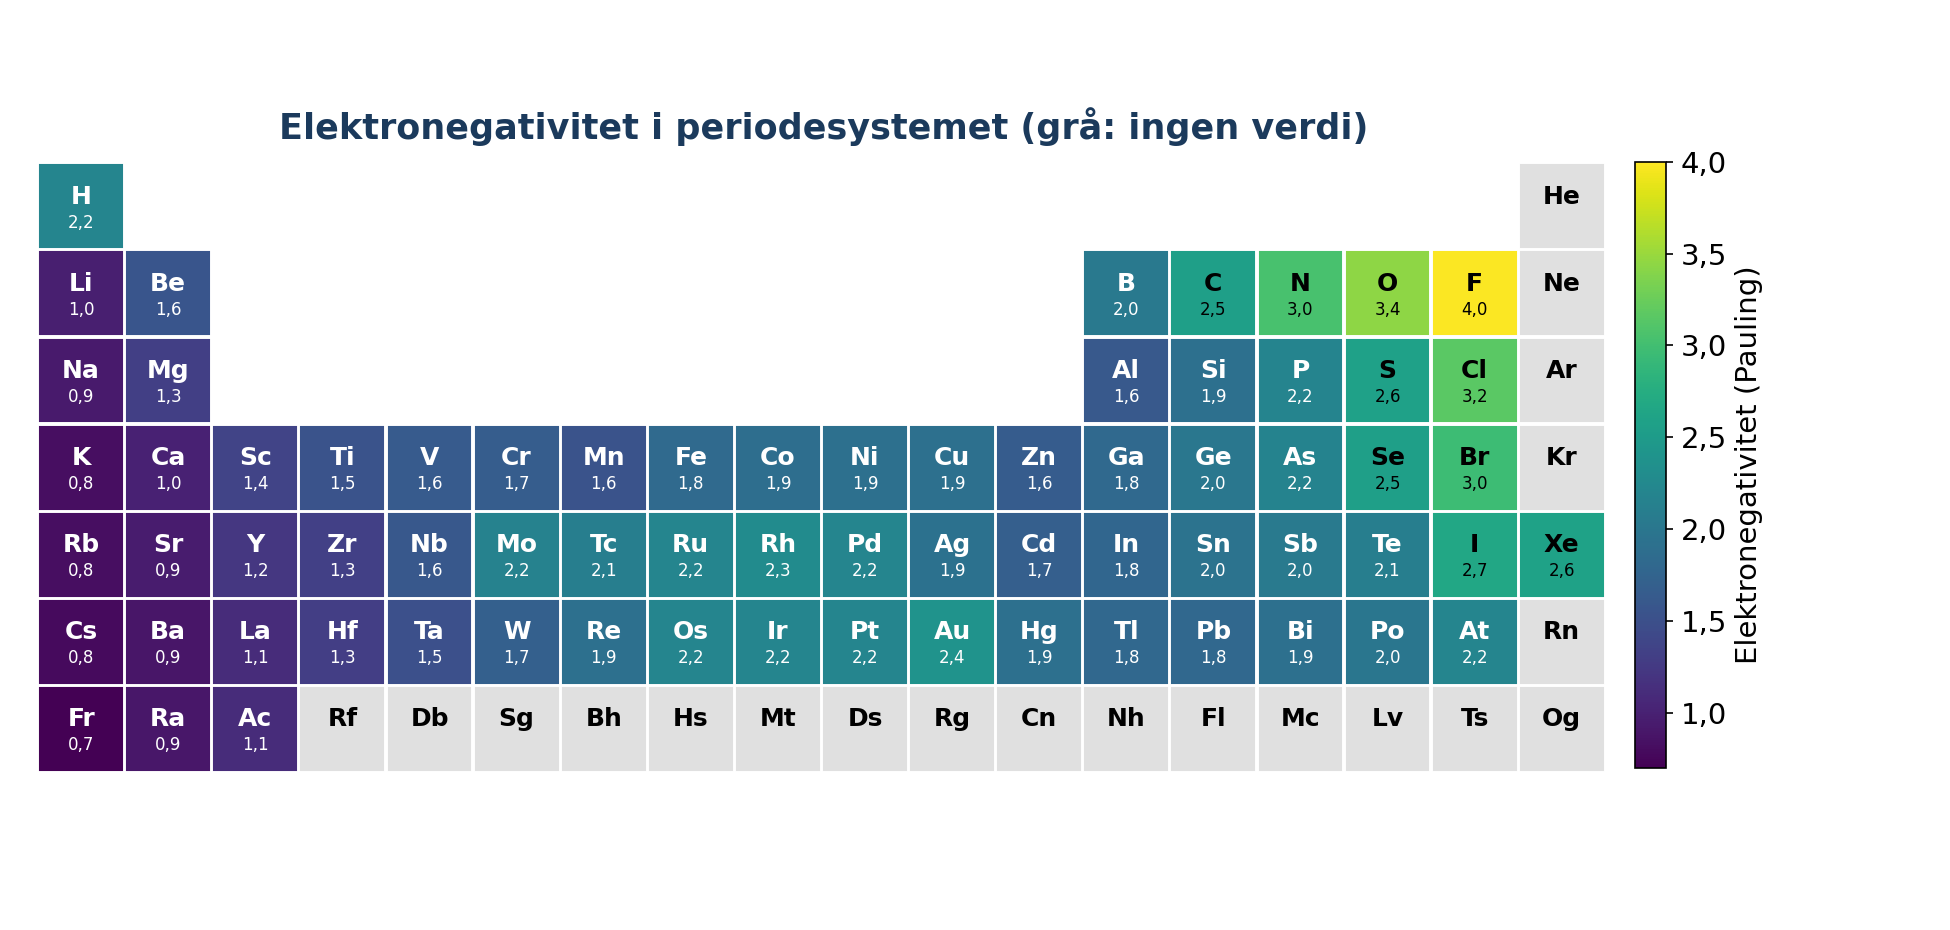
Periodesystemet kan betraktes som et stort datasett. Egenskaper som elektronegativitet, ioniseringsenergi og atomradius er samlet fra målinger og modeller. De kan ikke beregnes med noen få linjer kode, så her er et bibliotek til stor hjelp.
Grunnenheten i mendeleev er element. Vi kan hente et grunnstoff med symbol eller atomnummer, og deretter lese av egenskapene som attributter: grunnstoff.egenskap.
from mendeleev import element
import matplotlib.pyplot as plt

svovel = element("S")

print(svovel.name)
print(svovel.atomic_number)
print(svovel.atomic_weight)
Elektronegativitet hentes med et metodekall, altså med parentes. Grunnen er at elektronegativitet kan defineres på flere måter, så vi må angi hvilken skala vi vil bruke.
print(svovel.electronegativity("pauling"))
Ioniseringsenergier#
Ioniseringsenergiene ligger i en dictionary der nøkkelen er ioniseringsgraden. natrium.ionenergies[1] gir altså første ioniseringsenergi i eV.
natrium = element("Na")
print(natrium.ionenergies[1], "eV")
Prøv selv: Plott de fem første ioniseringsenergiene til magnesium mot ioniseringsgrad. Hvor kommer det store spranget, og hvorfor akkurat der?
magnesium = element("Mg")
grader = [1, 2, 3, 4, 5]
energier = []

for grad in grader:
    energier.append(magnesium.ionenergies[grad])

plt.plot(grader, energier, marker="o")
plt.xlabel("Ioniseringsgrad")
plt.ylabel("Ioniseringsenergi (eV)")
plt.show()
Del 2: Data om forbindelser med PubChemPy#
PubChem er en åpen database med informasjon om millioner av kjemiske forbindelser. Biblioteket pubchempy henter data fra PubChem over internett mens koden kjører. Det betyr at vi trenger nettilgang, og at mange oppslag kan ta tid.
Vi søker på et navn og får tilbake ei liste med treff. Det første treffet er som regel det vi er ute etter.
import pubchempy as pcp

treff = pcp.get_compounds("paracetamol", "name")
paracetamol = treff[0]

print("PubChem CID:", paracetamol.cid)
print("Molekylformel:", paracetamol.molecular_formula)
print("Molar masse:", paracetamol.molecular_weight, "g/mol")
print("SMILES:", paracetamol.smiles)
Prøv selv: Fyll inn programmet nedenfor slik at det henter SMILES-koden for hvert stoff i lista og lagrer den i en dictionary der navnet er nøkkelen.
navneliste = ["caffeine", "paracetamol", "aspirin", "ibuprofen"]
smiles_pubchem = {}

for navn in navneliste:
    forbindelse = pcp.get_compounds(navn, "name")[0]
    smiles_pubchem[navn] = forbindelse.smiles

print(smiles_pubchem)
Nettbaserte tjenester kan være trege eller endre seg. I resten av forelesningen bruker vi derfor dictionarien nedenfor, slik at vi ikke er avhengige av nettet.
smiles = {
    "koffein": "CN1C=NC2=C1C(=O)N(C)C(=O)N2C",
    "paracetamol": "CC(=O)Nc1ccc(O)cc1",
    "acetylsalisylsyre": "CC(=O)Oc1ccccc1C(=O)O",
    "ibuprofen": "CC(C)Cc1ccc(cc1)C(C)C(=O)O",
}
Del 3: Molekyler som struktur med RDKit#
RDKit arbeider med selve molekylstrukturen, ikke bare molekylformelen. Det gjør at vi kan bevege oss mellom ulike representasjoner av den samme forbindelsen:
symbolsk: SMILES-koden
CCOrepresenterer etanoltodimensjonal: en strukturformel
tredimensjonal: en konformasjon med bindingslengder og vinkler
beregnede egenskaper: molar masse, polaritet, antall H-bindingsdonorer og så videre
SMILES#
SMILES er en måte å skrive en molekylstruktur som tekst.
Regel |
Eksempel |
|---|---|
Atomer skrives med symbol. H-atomer utelates og legges til automatisk. |
|
|
|
Parenteser angir sidegrener |
|
Tall åpner og lukker ringer |
|
Små bokstaver angir aromatiske atomer |
|
from rdkit import Chem
from rdkit.Chem import Draw, Descriptors, AllChem
from rdkit.Chem.Draw import IPythonConsole

koffein = Chem.MolFromSmiles(smiles["koffein"])
koffein
Chem.MolFromSmiles returnerer None hvis SMILES-koden er ugyldig. Hva skjer hvis vi prøver Chem.MolFromSmiles("C1CC")? Hvorfor er den ugyldig?
Fra struktur til egenskap#
Når RDKit har lest inn en struktur, kan biblioteket beregne molekyldeskriptorer. En deskriptor er et tall som beskriver en egenskap ved molekylet.
Funksjon |
Hva den gir |
|---|---|
|
molar masse |
|
estimert logP, et mål på hvor lipofilt stoffet er |
|
topologisk polart overflateareal |
|
antall H-bindingsdonorer |
|
antall H-bindingsakseptorer |
Legg merke til at noen av disse er direkte opptellinger fra strukturen, mens logP er et modellestimat.
Del 4: Fra 2D til 3D#
Proteiner fra Protein Data Bank#
Store biomolekyler lager vi ikke fra SMILES. Eksperimentelt bestemte strukturer ligger i Protein Data Bank (PDB), der hver struktur har en ID på fire tegn. py3Dmol kan hente strukturen direkte.
Vi ser på hemoglobin (PDB-ID 4HHB). Proteinet består av fire kjeder, og hver kjede har en hemgruppe der O2 bindes til et jernatom. Vi viser proteinet som cartoon, som viser sekundærstrukturen (α-helikser), og hemgruppene som pinnemodell.
import py3Dmol

visning = py3Dmol.view(query="pdb:4HHB", width=500, height=400)
visning.setStyle({"cartoon": {"color": "spectrum"}})
visning.addStyle({"resn": "HEM"}, {"stick": {}})
visning.zoomTo()
visning.show()
3Dmol.js failed to load for some reason. Please check your browser console for error messages.
Prøv selv: Vis keratin (PDB-ID 6EC0) eller et enzym du selv velger. Prøv å fargelegge kjedene ulikt med {"cartoon": {"colorscheme": "chain"}}. Hvilken sekundærstruktur dominerer i keratin, og hvordan passer det med at keratin finnes i hår og negler?
Alternativ: Biblioteket nglview er laget spesielt for store biomolekyler og simuleringsdata.
Vurdere et bibliotek#
Det viktigste er ikke å huske syntaksen, men å kunne vurdere om et bibliotek passer til oppgaven:
Er biblioteket vedlikeholdt og dokumentert?
Hva tilfører det? Data, algoritmer eller standardisering?
Hvilke avhengigheter og begrensninger har det?
Kan vi kontrollere resultatet mot en håndberegning, en tabellverdi eller en annen kilde?
Dette gjelder også kode fra KI-verktøy. De kan foreslå funksjoner og biblioteker som ser riktige ut, men som ikke finnes eller brukes på en annen måte.
Diskuter: Du ber en KI-chatbot om kode, og den bruker et kjemibibliotek du aldri har hørt om. Hva sjekker du før du stoler på resultatet?
Oppgaver:
Plott første ioniseringsenergi for grunnstoffene i tredje periode (Na til Ar). Beskriv trenden og forklar spesielt hvorfor den brytes ved Al og S.
Plott atomradius (
atomic_radius) som funksjon av atomnummer for grunnstoff 19 til 36. Forklar hva du ser, og hvorfor overgangsmetallene skiller seg ut.Velg fem legemidler eller naturstoffer. Hent SMILES fra PubChem, tegn strukturene i et rutenett og beregn logP og TPSA for hvert stoff. Lag et spredningsplott av logP mot TPSA og beskriv sammenhengen du ser.
Lag en 3D-modell av benzosyre som kule-pinne-modell og som kalottmodell. Vis deretter keratin (PDB-ID
6EC0) eller et annet protein du velger.